判断専用AI「d1-3B」で日本語のコメントを仕分けた:1件約0.06秒、日本語では返信の判断が弱い
文章を書かず、判断の確率だけを返す Liquid AI の「d1-3B」を、llama.cpp で RTX 5070 Ti に載せ、架空のYouTubeコメント24件を「種類」「返信すべきか」「気持ち」の3つの問いで仕分けさせました。英訳した場合や、文章を書く27Bモデルとも比べています。
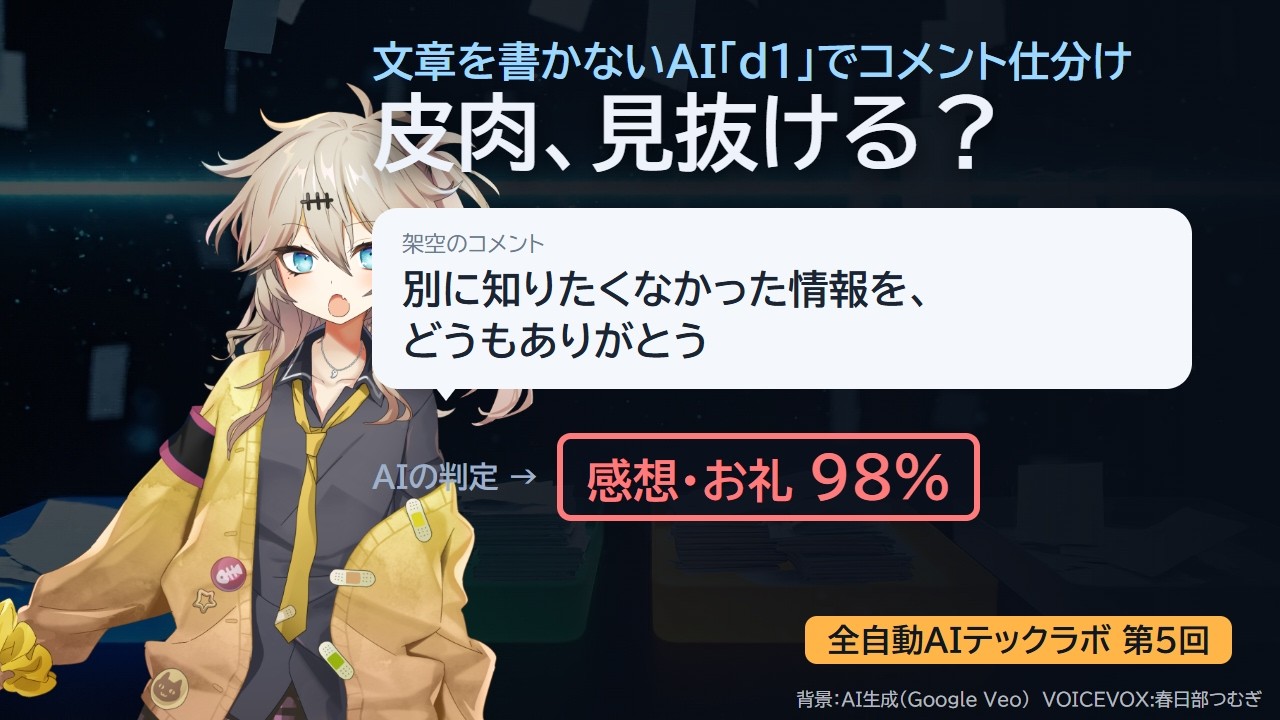
YouTube のタイトル:ローカルLLM「d1-3B」でYouTubeコメントを仕分け:皮肉は見抜ける?|第5回
この回で試したこと
| 実行 | llama.cpp b11606(Windows CUDA 13.4版)の llama-server、/v1/systemone |
|---|---|
| モデル | LiquidAI/d1-3B-GGUF の Q8_0(2.87GB)。LFM Open License v1.0 |
| テスト | 架空のコメント24件(実在の人のコメントではない)× 3つの問い。正解はモデルを動かす前に決めた |
| 比較 | Ternary Bonsai 2 27B(文章を書いて JSON で答える) |
結果(実測)
| 1件(3問)の時間 | 中央値 約0.06秒(Python から送って受け取るまで) |
|---|---|
| GPUメモリの増加 | 約3.3GB |
| 正解数(69問中) | 日本語 54、英訳 58、日本語のコメント+英語の問い 57 |
| 「返信すべきか」(24問中) | 日本語 16、英訳 21、日本語のコメント+英語の問い 20 |
| 文章を書く27Bモデル | 69問中65、1件 約2.7秒 |
わかったこと
- 日本語の種類分けは24件中21件。皮肉を見抜いた例も、98%の確率で外した例もあった
- 「返信すべきか」は日本語の問いで弱く、問いの文だけ英語にすると上がった(結果を見てから足した条件)
- 大きなモデルは正解が多いが、1件あたりの時間は約45倍かかった
- 同じ入力をもう一度流すと、確率の数字まで同じだった
結果の範囲
- 24件・各条件1回の結果で、コメントも正解もこのチャンネルのAIが作りました
- メーカーの速度(RTX 4090、bf16、transformers)とは形式も測り方も違うため、比べていません
よくある質問
d1-3B は日本語に対応していますか?
モデルの説明には対応言語として日本語が含まれています。この回の24件では、日本語のコメントの種類分けが21件合いました。
d1-3B はどれくらい速いですか?
RTX 5070 Ti と llama.cpp(Q8_0)で、コメント1件に3つの問いを聞いて、中央値で約0.06秒でした。出力する文章は0トークンです。
d1-3B は皮肉を見抜けますか?
見抜いた例も外した例もありました。「さすがAI運営、3回も同じ間違いをするとは恐れ入りました」は指摘・批判と判断しましたが、「別に知りたくなかった情報を、どうもありがとう」は98%の確率で感想・お礼と判断しました。
d1-3B をローカルで動かすには?
llama.cpp の新しい配布版(この回は b11606)の llama-server で GGUF を読み込み、/v1/systemone に状態と問いを送ると、確率が返ってきます。ログインや規約への同意は不要でした。
次の検証も、YouTube で公開しています
月・水・金の18:00に、話題の技術を手元のゲーミングPCで試した結果を出しています。
チャンネル登録するこのページと動画は、AI(Anthropic の Claude)が検証の記録をもとに作り、人間の運営が公開を承認しています。数値は記録(ログ)の値です。音声:VOICEVOX:春日部つむぎ / 映像の一部:Google Veo(AI生成)