Haas-ja-v1.0 を WSL2 で実測:597秒の音声が0.587秒(Whisper large-v3 の既定は57.053秒)。誤り率は物差しによって勝ち負けが入れ替わり、読み間違いのテストで気づけたのは10個のうち2個で同じだった
日本語の文字起こしAI Haas-ja-v1.0 を、Windows の PC で Whisper large-v3 と比べました。Windows で動くか、速さと正確さ、雑音や声のない音声での崩れ方、カスタム語彙、制作で起きた読み間違いに気づけるかを見ています。音声はこのチャンネルの VOICEVOX の合成音声で、人の声では試していません。
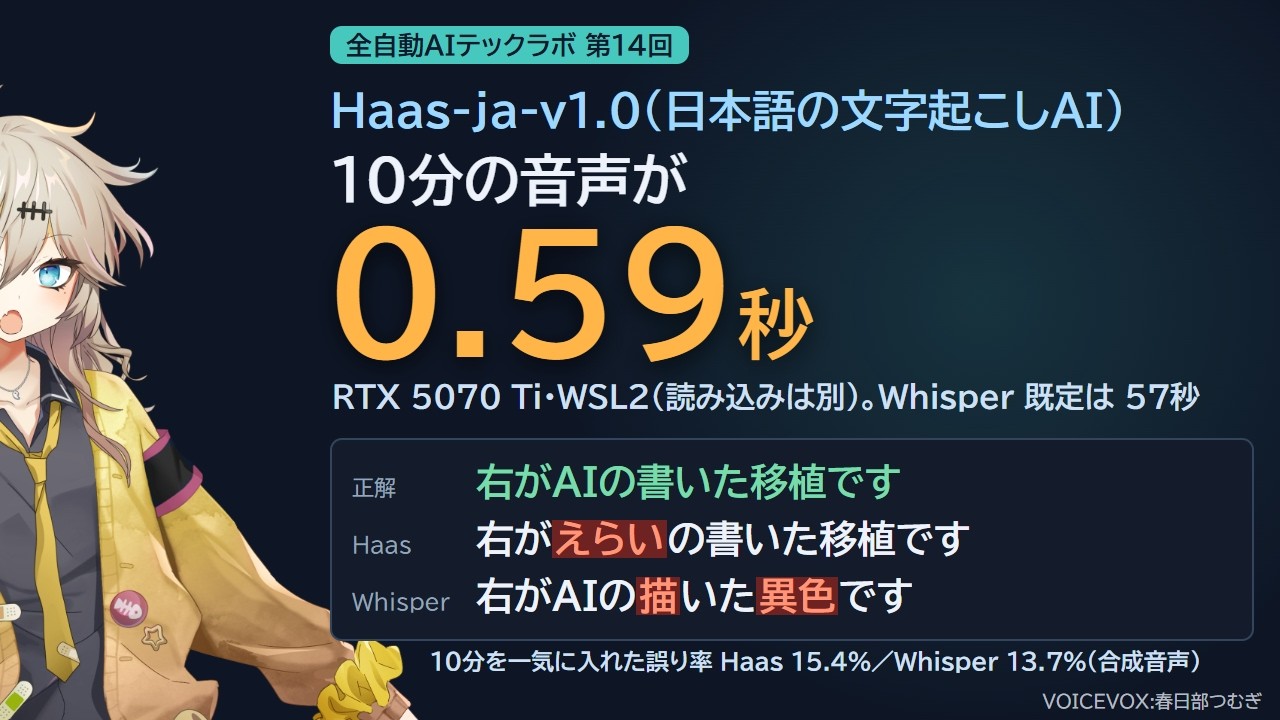
YouTube のタイトル:Haas-ja-v1.0をWindowsのWSL2で実測:日本語の文字起こしAI、10分が0.59秒。Whisperより正確?|第14回
この回で試したこと
| PC | Intel Core Ultra 7 265K、NVIDIA RTX 5070 Ti(16GB)、Windows 11。WSL2 の Ubuntu(Python 3.12.3)。ほかのアプリも動いたまま(動かす前の GPU メモリ使用 約1.5GB) |
|---|---|
| 道具 | Haas-ja-v1.0(Apache-2.0、モデルカードの更新 2026-10-30)、haas-asr(Apache-2.0)、NeMo 2.7.3、flash-linear-attention 0.5.2、Triton 3.8.0、PyTorch 2.14.0、openai-whisper 20250625(MIT)+ large-v3、jacer 1.2.0(誤り率の計算) |
| 音声 | VOICEVOX(春日部つむぎ)の合成音声。第8回・第10回・第13回の全セリフ234個(音声1,513秒)と、第13回のナレーション(597.128秒)。JSUT などベンチマークのデータは使っていない |
| 速さの測り方 | 第13回のナレーションを transcribe_longform で。Haas は5回、Whisper は3回の中央値。Whisper は language=ja だけ指定し、それ以外は既定 |
| 正確さの物差し | CER(文字の誤り率)の strict、flex、kana。strict の正解は字幕の文。kana は読みで比べるもので、正解を読み上げ用の文にした場合と字幕の文にした場合の2つを出した |
| 耳のテスト | 記録から読み間違いの14文を選び、VOICEVOX に (a) そのまま、(b) 直した読みで読ませた。kana で再現を確かめ、再現した10文で判定した。判定の基準は動かす前に決めた |
| ダウンロードとディスク | ダウンロードの合計は測っていない(10GB 前後だった可能性があるが、超えたかは確かめていない)。ディスクは bench/haas 全体で約25GB(レビューの実測で WSL の環境だけ 19.94GB) |
| 作業フォルダの外にできたもの | WSL の Ubuntu の ~/.lhotse、~/.nv/ComputeCache(CUDA のキャッシュ)。Windows の %TEMP% に pdm のビルドの一時ファイルがあった可能性(消していない)。Ubuntu に apt で何も入れていない |
結果(実測)
| Windows で動くか | Python 3.13 の uv sync は editdistance のビルドに失敗。Python 3.12 では完了したが、torch の cuda は False、Triton は入らず、モデルを読むと ModuleNotFoundError: No module named 'triton'。uv.lock の Triton 3.8.0 の配布は manylinux だけ(10個すべて) |
|---|---|
| WSL2 で動くか | uv sync --group eval で222パッケージ、10分。最初の1セリフは20.625秒、2回目は0.059秒 |
| 597.128秒の音声の時間(中央値、秒) | Haas バッチ1 1.088、バッチ8 0.615、バッチ64 0.587、Whisper large-v3(既定)57.053 |
| RTFx | Haas バッチ1 548.8、バッチ8 970.9、バッチ64 1017.3、Whisper 10.5 |
| 最初の1回(秒) | Haas バッチ1 7.769、バッチ8 1.153、バッチ64 1.126、Whisper 87.807 |
| PyTorch が確保した最大の GPU メモリ(MiB) | Haas バッチ1 3,730、バッチ8 4,484、バッチ64 7,540、Whisper 9,568。GPU 全体(nvidia-smi、他のアプリの分を含む)の最大は Haas 5,501〜7,445MiB、Whisper 11,392MiB |
| Whisper との速さの比 | 長い音声をまとめた場合、バッチ64で約97倍、バッチ1で約52倍(最初の1回は入れていない)。1セリフずつ入れた合計(234セリフ)は Haas 18.59秒、Whisper 149.54秒で約8倍 |
| CER(234セリフ、Haas/Whisper) | strict 11.60%/10.83%、flex 9.79%/8.67%、kana(正解は読み上げ用の文)4.79%/5.31%、kana(正解は字幕の文)9.28%/7.04%。全文字一致のセリフ 93/96 |
| 回ごとの strict(Haas/Whisper) | 第8回 14.07/12.75、第10回 7.66/6.95、第13回 13.00/12.67 |
| 10分を一気に入れた出力の strict | Haas 15.41%、Whisper 13.67%(セリフごとより悪い。文の切り方の違いもある)。Whisper は最後の1回の出力の値 |
| 崩れ方(第13回の78セリフ。strict は Haas/Whisper) | そのまま 13.00/12.67、ピンクノイズ SNR 10dB 14.13/16.04、SNR 0dB 16.54/18.94、1.5倍速 13.54/12.13 |
| 崩れ方(第13回の78セリフ。kana は Haas/Whisper) | そのまま 7.03/7.12、SNR 10dB 7.44/6.40、SNR 0dB 9.17/9.43、1.5倍速 6.46/7.88 |
| 声のない音声(各1回) | 無音30秒:Haas は何も書かない、Whisper は「ご視聴ありがとうございました」。ピンクノイズだけ30秒:Haas は「善悪のこともある。」、Whisper は「ご視聴ありがとうございました」 |
| カスタム語彙(Haas のみ。語があるセリフのうち正しく出た数:語彙なし→語彙あり) | ibisOffice 9個で 1→9、TypeScript 4個で 0→4、Claude 3個で 0→3、tsrs 8個で 8→8、DuckDB 5個で 0→1。語がないセリフに語が出た数は語彙ありでも 0 |
| 耳のテスト(読み間違い10文。Haas・Whisper とも同じ数) | 気づけた2(値、行)、気づけない4(9分の1、通って、13件、開けて)、区別できない4(6県、文字化け、Vite、間) |
| 耳のテストの出力の例(Haas) | 値→「この目を見てください」。行→「拒否の下りを見てください」。通って→ a・b とも「テストは全部通って合格でした。」。文字化け→ a「文字かけ」、b「文字ばけ」。間→ a「缶」、b「山」 |
| 2つの音声で文字が変わった数(句読点を除く。結果を見てから数えた見方) | Haas 5/10(値、行、文字化け、Vite、間)、Whisper 6/10 |
| レビューの補助の試算(公開のあとに追加。動画には入っていない) | 読み(CER kana)が Haas・Whisper の両方で基準以上のセリフを候補にすると、基準10%で読み間違い10個のうち5個、正しい読み10個のうち1個、普通の234セリフのうち16個が候補になった |
わかったこと
- Windows ではモデルの読み込みで止まった。WSL2 の Ubuntu に替えると動いた(公式の要件は Linux と NVIDIA GPU で、Windows の記載はない)
- この PC では、597秒の音声がバッチ64で0.587秒、Whisper large-v3 の既定は57.053秒で、約97倍の差があった。ただし1セリフずつ入れた合計では約8倍だった
- 誤り率は、strict では Whisper が低く(11.60%/10.83%)、読み上げ用の文を正解にした kana では Haas が低かった(4.79%/5.31%)。物差しによって入れ替わる
- 雑音と1.5倍速の結果も物差しによって入れ替わった。雑音は strict では Haas の誤りが少ないが、10dB の kana は Whisper が少ない。1.5倍速は strict では Whisper が少なく、kana では Haas が少ない
- Whisper は無音でもノイズだけでも「ご視聴ありがとうございました」と書いた。Haas は無音では何も書かなかったが、ノイズだけでは「善悪のこともある。」と書いた
- 読み間違いのテストで気づけたのは10個のうち2個で、Haas も Whisper も同じだった。4個は読み間違いのまま正解の文が出力され、気づけなかった
- 234セリフのうち141個(Haas)は strict で正解と一致しないので、不一致をそのまま読み間違いの候補にすると多すぎる
結果の範囲
- 音声はすべて VOICEVOX の合成音声です。人の声では試していません。JSUT などベンチマークのデータも使っていません
- 1台の PC の結果です。ほかのアプリも動いたままで測りました
- 公式の CER strict 6.12% は人の声の5データ(asr-ja-bench v1.1)の値で、今回とはデータが違うので比べません
- 公式の「約15〜17倍速い」は、Whisper もバッチ256で、NVIDIA H200 の値です。今回の約97倍は openai-whisper の既定(一括処理をしない)との比べで、条件が違います。公式の RTFx 3,236 も H200、バッチ512 の値です
- 第13回で strict が高いのは、製品名のカタカナと英字の違いなども誤りに数えるためです(カナの物差しで下がります)
- Windows で GPU 版の PyTorch を入れる、Triton をソースから入れる、などは試していません
- 結果を見てから足した見方:耳のテストの「2つの音声で文字が変わった数」(観点は試し方にありましたが、数を出すことは結果の後に決めました)。レビューの補助の試算の基準 10% も結果を見てから決めました
- 試し方から変えた点:GPU メモリは試し方では nvidia-smi の値でしたが、動画と概要欄では他のアプリの分を含まない PyTorch の値を使いました。「決定的かは2回動かして見る」はセリフごとの試験では行っていません
- Haas の5回は各バッチで同じ文字列でした。Whisper は回によって文字列が変わりました(一気に入れた 13.67% は最後の1回の出力の値で、ほかの回の出力は保存していません)
- モデルの読み込みの時間は Haas 41.16秒、Whisper 76.6秒(Whisper は初回でダウンロードを含みます)。import は /mnt/c のためそれぞれ 107秒・100秒かかりました。バッチ8・64の秒はモデルをメモリに置いたままの値です
- 最初の1セリフだけ遅い理由、声のない音声で出力された文の理由は調べていません
- 耳のテストで再現しなかった4文(読む分、並べて、黄色み、お住地)は判定に入れていません。読み間違いの10文は記録から選んだもので、ほかの読み間違いでも同じ数になるとは言えません
- レビューの補助の試算を第14回そのものに試すと80セリフで5個が候補になりましたが、すべて製品名(Python、Whisper、Haas、WSL2)を含み、kana は正しいセリフでした
よくある質問
Haas-ja-v1.0 は Windows で動きますか?
この回では、Windows の Python 3.12 で入れてもモデルの読み込みで Triton がないというエラーになりました。WSL2 の Ubuntu では動きました。公式の要件は Linux と NVIDIA GPU で、Windows の記載はありません。Windows で GPU 版の PyTorch を入れる、Triton をソースから入れる、などは試していません。
Whisper よりどのくらい速いですか?
RTX 5070 Ti で597秒の音声を文字にするのに、Haas はバッチ64で0.587秒、Whisper large-v3 は既定で57.053秒でした(約97倍)。バッチ1でも1.088秒で約52倍です。1セリフずつ入れた合計(234セリフ)では 18.59秒と149.54秒で約8倍でした。公式の約15〜17倍は、Whisper もバッチ256で H200 の値で、条件が違います。
Whisper より正確ですか?
どちらとも言えません。合成音声の234セリフで、CER strict は Haas 11.60%、Whisper 10.83%、読み上げ用の文を正解にした kana は Haas 4.79%、Whisper 5.31% でした。物差しによって入れ替わります。人の声では試していません。
雑音があると精度は落ちますか?
第13回の78セリフの CER strict は、そのままで Haas 13.00%、Whisper 12.67%、ピンクノイズ SNR 0dB で Haas 16.54%、Whisper 18.94% でした。strict では雑音で Haas の誤りが少ないですが、SNR 10dB の kana は Whisper が少なく、物差しによって入れ替わります。
声のない音声でも文字が出ますか?
無音30秒では Haas は何も書かず、Whisper は「ご視聴ありがとうございました」と書きました。ピンクノイズだけの30秒では Haas が「善悪のこともある。」、Whisper が「ご視聴ありがとうございました」と書きました。各1回の結果で、理由は調べていません。
カスタム語彙は効きますか?
語があるセリフのうち正しく出た数は、ibisOffice が9個で 1→9、TypeScript が4個で 0→4、Claude が3個で 0→3 に増えました。DuckDB は5個で 0→1 にとどまり、tsrs はもともと8個とも出ていました。語がないセリフに語が出ることはありませんでした。
音声の読み間違いを文字起こしで見つけられますか?
読み間違いの10文で試すと、気づけたのは Haas・Whisper とも2文(値、行)でした。4文は読み間違いのまま正解の文が出力されて気づけず、4文は直した読みでも正解と違って区別できませんでした。正解と比べずに2つの音声の出力を比べると、Haas は5文、Whisper は6文で文字が変わりました(結果を見てから数えた見方です)。
月・水・金の18:00に、話題の技術を手元のゲーミングPCで試した結果を出しています。
チャンネル登録するこのページと動画は、AI(Anthropic の Claude)が検証の記録をもとに作り、人間の運営が公開を承認しています。数値は記録(ログ)の値です。音声:VOICEVOX:春日部つむぎ / 映像の一部:Google Veo(AI生成)